一篇模型生成的文章被复制到别处,来源标签很容易丢失。再经过删句、替换或改写,剩下的文字还能留下什么线索?
PURA 研究的,是在生成时写入一小串预先约定的位,再从文本中恢复它。它可以代表系统、版本等来源编号。这串编号不是自动识别出的真人身份。
01 / 采样
选出一个词,
也可以看成投下一个点。
模型给出每个候选词的概率。把这些概率铺成首尾相接的区间,再在 0 到 1 之间均匀选一个随机点。点落在哪段,就输出哪个词。
区间越宽,接住随机点的机会越多。这就是逆变换采样(ITS)的直觉:只要点整体仍然均匀,各词出现的概率就仍然与区间宽度一致。
02 / 嵌入
不改词的概率,
而是转动背后的随机数。
把刚才的尺子首尾相连,就得到一个圆。PURA 用载荷选出的 Gray 扇区决定一个偏移量,把基准随机点旋转,再按原来的概率区间选词。
A = (U + (S + 0.5) / K) mod 1
论文示例取 U = 0.15、S = 1、K = 4,偏移量为 0.375,得到 A = 0.525。它落在示例词表中“海”的区间里。
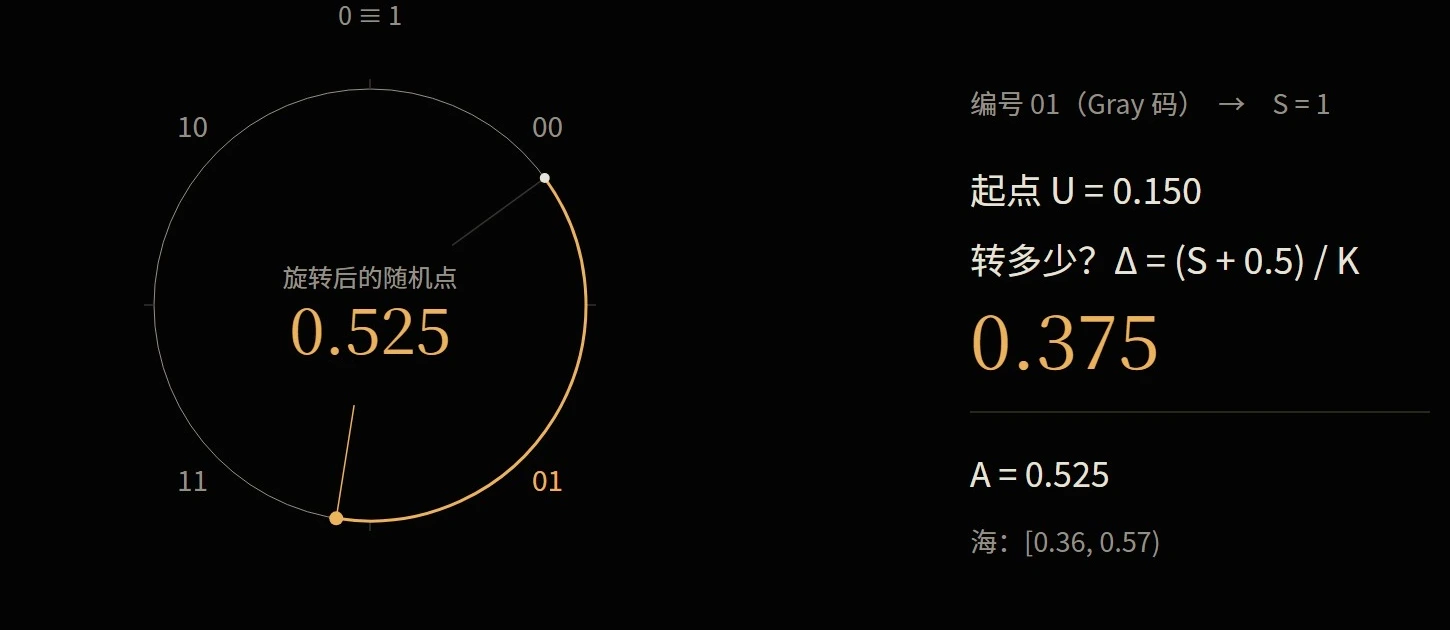
整个均匀点云一起旋转后,仍然均匀。单次选中的词可以改变,但整体分布可以保持。论文的计算无偏性还有伪随机函数、域分离、有效种子上下文不重复等前提,并针对单次调用;不能直接扩展为固定密钥跨样本的绝对安全。
03 / 恢复
一个词,
保留的是一段不确定性。
观察到“海”,只能知道采样点落在 [0.36, 0.57);无法把它反解成唯一随机点。验证方需要密钥,以及源模型或兼容代理模型重建的概率,才能重新建立这个秘密区间。
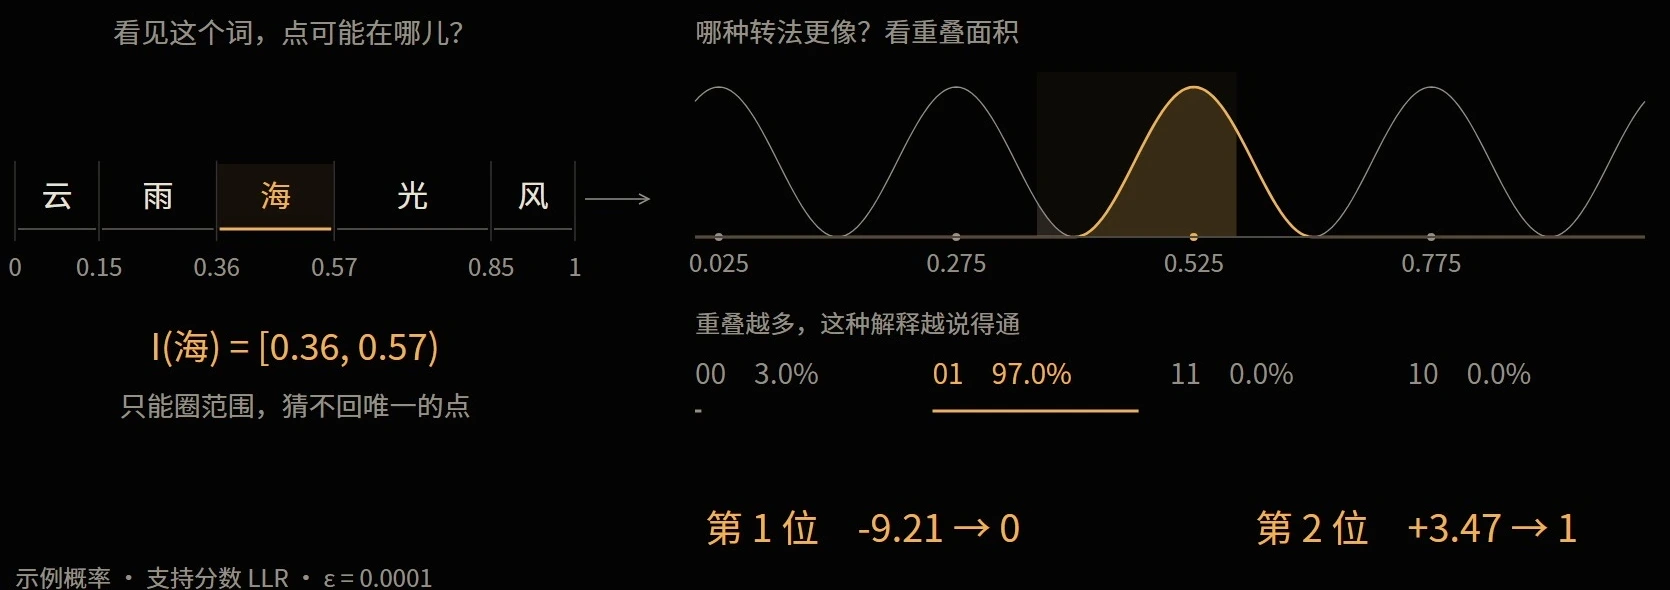
把候选按 Gray 码某一位是 0 还是 1 分组,将权重比例取对数,就得到局部 LLR。正号支持 1,负号支持 0;绝对值表示证据强弱。同一位在不同位置的证据相加,弱线索才可能积少成多。
+0.42 +0.94 −0.30 +0.41 = +1.47
Figure 2C 的局部证据累加示例。